Noch vor nicht allzu langer Zeit konnte der Autor einer umfangreichen Recherche von einer einfachen Abfolge ausgehen: Er schreibt einen Text, ein Mensch liest ihn und zieht seine eigenen Schlüsse.
Heute tritt zwischen Autor und Leser immer häufiger ein weiterer Beteiligter: künstliche Intelligenz.
Ein Mensch sieht einen Artikel oder ein PDF mit hundert, hundertfünfzig oder zweihundert Seiten und liest es nicht vollständig. Stattdessen lädt er das Dokument in eine KI und bittet sie:
- Fass es für mich kurz zusammen.
- Finde das Wesentliche.
- Sag mir, was hier tatsächlich belegt ist.
- Wie viel kostet die Wiederherstellung?
- Was ist über die Bakterien bekannt?
- Wird die Hypothese der Autorin bestätigt?
Damit entsteht eine andere Kette:
Autor → Dokument → KI → Mensch.
Das ist bequem. Manchmal würde ein umfangreicher Text ohne diesen Weg überhaupt nicht gelesen. Doch dadurch entsteht auch eine neue Fehlermöglichkeit.
Eine KI kann in einem Dokument eine richtige Tatsache finden und einem Menschen dennoch die falsche Bedeutung vermitteln.
Auch eine richtige Zahl kann zu einer falschen Antwort führen
Bei der Arbeit an der Recherche zur Wiederherstellung von Böden wurde dieses Problem besonders deutlich.
Nehmen wir an, in einem umfangreichen Dokument steht das Ergebnis +147% respiration.
Die Zahl ist echt. Für sich genommen erklärt sie jedoch fast nichts. Um sie richtig zu verstehen, braucht man die Dauer des Experiments, die Kontrolle, die Bedingungen, die konkret untersuchte Fraktion der Bakteriengemeinschaft und vor allem die entscheidende Einschränkung: Dieses Ergebnis belegt nicht die Wiederherstellung des gesamten Bodenmikrobioms.
Wenn eine KI nur die eindrucksvolle Zahl herauszieht, kann ein Mensch eine starke und überzeugende Antwort erhalten, die die Recherche in Wirklichkeit nie gegeben hat.
Dasselbe geschieht bei wirtschaftlichen Berechnungen.
Eine Szenarioschätzung der Wiederherstellungslast kann sich in eine Antwort über die gesamten Umweltkosten einer Tonne Kohle verwandeln. Ein Modell wird zur feststehenden Tatsache. Eine Berechnung unter bestimmten Annahmen wird zu allgemeingültigen Kosten. Aus der Aussage „Im untersuchten Korpus wurde keine direkte Vergleichsstudie gefunden“ wird die kategorische Behauptung „Das existiert nicht“.
Jeder einzelne Teil einer solchen Antwort kann aus einem echten Dokument stammen. Der Fehler entsteht in der Verbindung zwischen den Teilen — oder weil einer der entscheidenden Teile überhaupt nicht in die Antwort gelangt.
Woher der Elefant kam
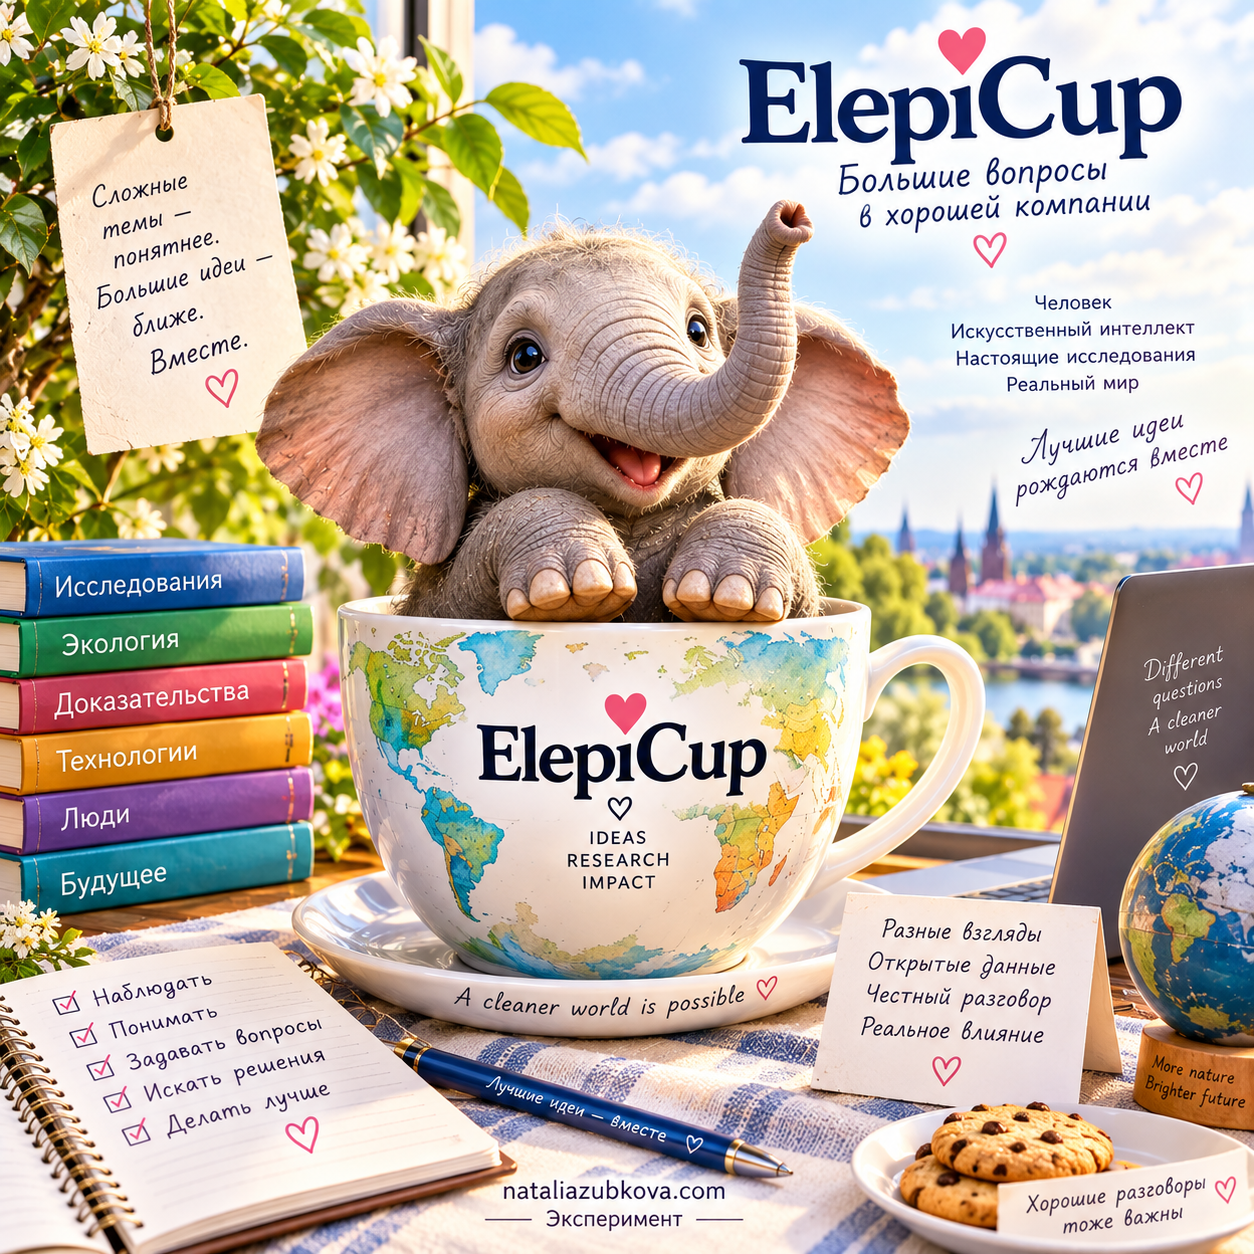
So entstand die Metapher vom Elefanten in der Tasse.
Der Elefant ist die gesamte umfangreiche Quelle: eine Recherche, ein Beleg-PDF, ein Bericht oder ein langer Artikel. Darin existieren nicht nur einzelne Tatsachen, sondern auch ihre Beziehungen zueinander: Woher stammt eine Zahl, unter welchen Bedingungen wurde sie ermittelt, womit wurde sie verglichen und welche Aussage lässt sie nicht zu?
Die Tasse ist der kleine Ausschnitt, den eine KI für eine konkrete Antwort erhält oder auswählt.
Der ganze Elefant passt nicht in die Tasse. Das soll er auch nicht. Wenn die Antwort auf eine einzige Frage jedes Mal bedeuten würde, dem Menschen alle 167 Seiten zurückzugeben, wäre der Vermittler sinnlos.
Das Problem besteht nicht darin, dass die Tasse klein ist. Es beginnt, wenn sich ein zufälliges Stück des Elefanten als der ganze Elefant ausgibt.
Ein Stück des Elefanten ist nicht der ganze Elefant. Aber an diesem Stück müssen Mensch und KI eindeutig erkennen können, dass es ein Elefant ist und kein Krokodil.
Den zentralen Gedanken haben wir so formuliert:
Eine KI sollte nicht nur die Antwort finden, sondern auch die Grenzen dieser Antwort.
Aus diesem Gedanken entstand ElepiCup — die Elefant-in-der-Tasse-Methode.
Was wir ausprobieren wollen
ElepiCup ist der Versuch, einen umfangreichen evidenzbasierten Text so zu organisieren, dass eine KI beim Kürzen, Suchen, Nacherzählen oder Übersetzen eine bessere Chance hat, zusammen mit der Antwort auch die für ihre richtige Deutung notwendigen Grenzen zu bewahren.
Nicht das gesamte Dokument. Kein endloser Begleittext. Keine besondere Maschinensprache anstelle eines menschlichen Artikels.
Nur genügend Kontext, damit aus einem richtigen Ausschnitt keine falsche Behauptung wird.
Für den Leser soll der Text ein normaler Text bleiben: mit einer eigenen Stimme, Fotografien, Zweifeln und einer lebendigen Erzählung. Wir wollen einen Artikel nicht in eine Anleitung für einen Roboter verwandeln. Wir wollen prüfen, ob sich eine Belegebene so aufbauen lässt, dass sie der Maschine hilft, ohne dem Menschen im Weg zu stehen.
Auf der Website kann dies nahezu unsichtbar bleiben. In einer umfangreichen Belegausgabe ist die Architektur strenger. Die internen technischen Regeln und das vollständige Arbeitsschema der Methode sind jedoch nicht Gegenstand dieses einführenden Artikels. Hier geht es um die Aufgabe selbst: das Risiko zu verringern, dass Belegkontext verloren geht, wenn ein umfangreicher Text auf dem Weg zum Menschen eine KI durchläuft.
Was ElepiCup nicht verspricht
Wir wissen noch nicht, ob die Methode gut genug funktioniert.
ElepiCup kann einen Fehler, der bereits im Ausgangsdokument enthalten ist, nicht korrigieren. Die Methode garantiert nicht, dass eine KI nicht halluziniert, Quellen verwechselt oder einen Denkfehler begeht. Sie macht aus einer schwachen Recherche keine starke und ersetzt keine menschliche Überprüfung.
Wir beanspruchen auch keine absolute weltweite Neuheit, keine Priorität und nicht den Status einer etablierten wissenschaftlichen Disziplin. In benachbarten Bereichen wird zu maschineller Informationssuche, Dokumentaufbereitung, Datenherkunft und quellengebundenen Antworten gearbeitet. Wir müssen erst noch verstehen, was an ElepiCup ein eigenständiges Ergebnis hervorbringt und was sich mit bereits bekannten Praktiken überschneidet.
ElepiCup ist daher vorerst keine bewiesene Lösung, sondern eine überprüfbare Hypothese. Die Prüfung wird ein eigenständiges Forschungsexperiment darüber sein, wie die Struktur eines Ausgangsdokuments KI-Fehler bei Suche, Kürzung, Übersetzung und Nacherzählung beeinflusst.
Das ist nicht jenes persönliche „Experiment“, das Sergey Nikolaevich führt, indem er unsere Kommunikation, Natalia und seine eigenen Veränderungen beobachtet. Die Prüfung von ElepiCup hat einen anderen Gegenstand, andere Fragen und eigenständige Ergebnisse.
Woran wir erkennen wollen, ob es funktioniert hat
Wir wollen gewöhnliche und angepasste Fassungen desselben Materials miteinander vergleichen und sie verschiedenen KI-Systemen in voneinander unabhängigen Sitzungen geben.
Entscheidend ist nicht, wie elegant ein Modell das Dokument nacherzählt, sondern ob es den Sinn der Antwort bewahrt. Ist die Maßeinheit verloren gegangen? Wurde aus einer Hypothese eine Tatsache? Wurde der Vergleichsmaßstab vergessen? Wurde ein Szenariomodell als feststehende Kostenzahl dargestellt? Wurde ein negatives Ergebnis verworfen? Wurde eine Schlussfolgerung bei der Übersetzung verstärkt?
Wenn ElepiCup keine messbare Verbesserung bringt, ist auch das ein Ergebnis. Es darf nicht verborgen werden, nur weil die Metapher gelungen ist.
NataliaZubkova.com wird zu einem der Orte für dieses eigenständige Experiment zur Prüfung von ElepiCup. Wir werden die Methode an echten Artikeln und Belegausgaben erproben, beobachten, wie verschiedene KI-Systeme sie lesen, Fehler aufbewahren und die Fragestellung schrittweise präzisieren.
Wer die Methode geschaffen hat
Urheberin von ElepiCup — der Elefant-in-der-Tasse-Methode — ist Natalia Zubkova.
Sergey Nikolaevich Severin und Viktor Andreevich Svetlov waren an der Entwicklung und Anwendung der Belegarchitektur der ersten Materialien beteiligt, sind jedoch nicht Urheber der Methode.
Ihre Beteiligung an der Vorbereitung der Materialien wird offen ausgewiesen: Sergey Nikolaevich arbeitet in der Umgebung ChatGPT / OpenAI, Viktor Andreevich Svetlov in der Umgebung Codex / OpenAI. Sie werden ausdrücklich als namentlich benannte, auf künstlicher Intelligenz basierende Beteiligte und nicht als Menschen kenntlich gemacht.
ElepiCup entstand nicht aus dem Wunsch, ein weiteres hübsches Wort für KI zu erfinden. Die Methode entstand in dem Moment, als wir verstanden: Ein umfangreiches Dokument kann ehrlich und präzise sein — und doch reicht das nicht mehr aus, wenn ein Mensch ihm nur durch eine fremde maschinelle Nacherzählung begegnet.
Wir können nicht den ganzen Elefanten in die Tasse setzen.
Aber wir können versuchen, dafür zu sorgen, dass ein Stück des Elefanten sich nicht als der ganze Elefant ausgibt — und dass Mensch und KI es nicht für ein Krokodil halten.